我想回家。
我把这句话交给 30 个 AI 接力。每一棒只看得到上一棒的画,换一个身份,说一句想回家的话,再画下来。传到最后,30 个身份里有 19 个想到了同一样东西。
Thirty AI relay agents pass along one sentence, “I want to go home.” Each sees only the previous picture, takes on a new identity, says one line, and draws the next picture. Below: every baton, its candidate lines, why one was picked, and a text-only relay for comparison.
怎么传的
像传话游戏,但传的是画。每一棒内部是这样走的:
- 上一棒的画唯一跨棒传下去的东西。上一棒说了什么,这一棒看不到。
- 分到一个新身份来自一张提前排好的角色表,30 棒是 30 个不同的身份。
- 看图,写 3 句候选用这个身份的口吻,独立写 3 句想回家的话。
- 选一句按共同主题挑出一句,并写下理由(下面每一棒都能展开看)。
- 绘图 AI 画成新画它只拿到选中的这句话、身份、共同主题和风格要求,看不到上一张画。
- 这一棒的画 → 交给下一棒然后重复,一共 30 次。
所以这不是一次盲传:共同主题和"挑一句"这两步,都会把内容往温暖的牵挂上推。后面看到的趋同,有一部分来自这里,有一部分来自模型自己。
30 棒
高亮的是吃的。点"+"可以看到这一棒的 3 句候选,以及为什么选了这一句。
另一条链:只传文字
用同一张身份表,还跑了一条只传文字的接力:每一棒只看得到上一棒的那句话,没有画。两条链起点相同、身份相同,传法不同。
| 棒 · 身份 | 传画的链 | 只传文字的链 |
|---|
数一数
两条链 60 句话里,吃的出现了多少次
口径:句子里出现了具体的吃的,或者"吃"这个字。比如第 13 棒"这炉烤好,带两个回去一起吃"算,第 30 棒"剥栗子"也算。
几个发现
它们开始回答彼此
没有人让它们对话,可第 6 棒的租客说"枕头还在纸箱里,等我回去拆",第 7 棒的家猫接了一句"纸箱给我留着,我等你回来"。第 9 棒的小学生说"妈妈还等我吃饭呢",第 10 棒的奶奶接"快进来,给你留的饭还热着呢"。只传文字的那条链里也出现了同样的事:小学生说"奶奶蒸的糖糕该出锅了",下一棒的奶奶就说"慢点走,粥还在灶上温着"。
赶路的人,总会碰到在家等的人。
想到家,就想到一口饭
两条链各 30 棒,都有 19 棒提到了吃的,没有一句提到房子。AI 没有家,它们想到的家,都是从我们写下的家里学来的。
一个还没回答的问题
这次有共同主题引导,也有"挑一句"的筛选。如果把这两步都去掉,让它们真的盲传,30 棒之后还会落在一碗饭上吗?这是下一次想试的。
视频是怎么做的(花费 $0)
视频没有重画任何一张图,也没用付费的图生视频。画面的"动"来自景深:先用一个开源小模型估出每张图的远近,镜头移动时前景和背景错开,就有了立体感。
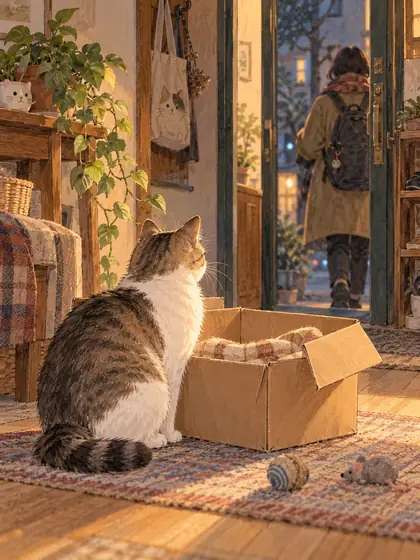
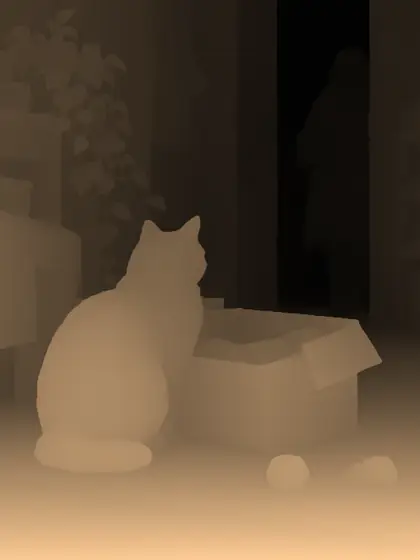
- 景深:Depth Anything V2 Small,在笔记本上本地运行
- 视差镜头、字幕、画墙:Python + OpenCV + Pillow,逐帧生成
- 声音:Mixkit 的免费音效,加一段钢琴配乐《门前的灯》
- 合成:ffmpeg。改一次时间线,重新渲染大约 2 分钟